Immersive Audiotechnologien verändern, wie Klang in Konzerthäusern, Theatern und Events produziert und wiedergegeben wird. Für AV-Planer bedeutet das einen Perspektivwechsel vom Routing von Kanälen zur Gestaltung von Klangräumen. Ein Überblick über Technologien und Systemanforderungen mit Entscheidungshilfen für die Praxis.
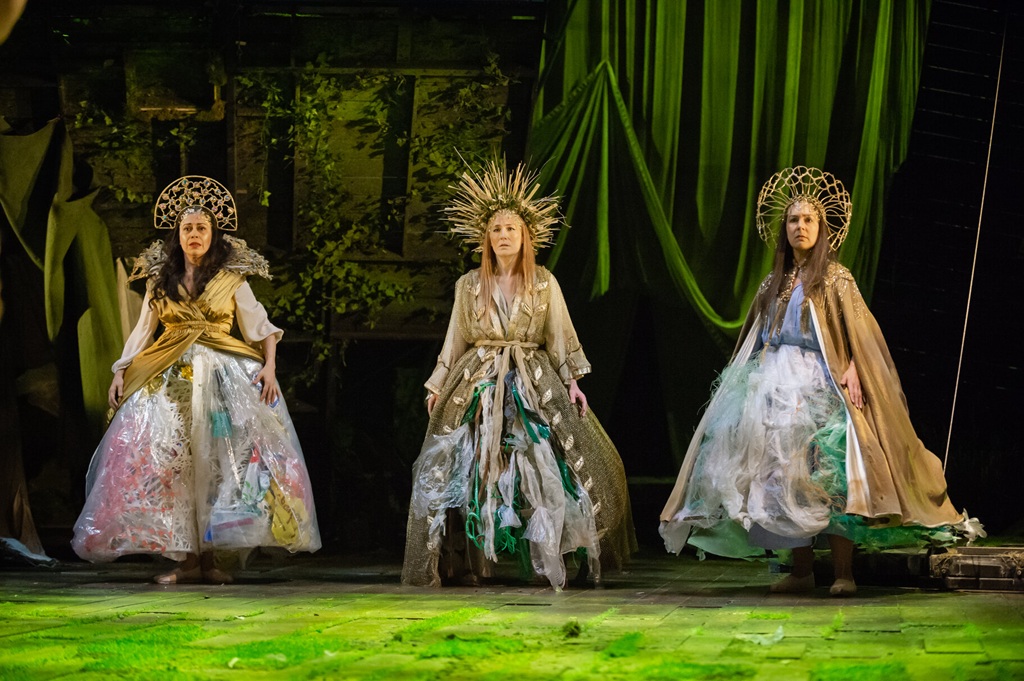
Die Tempest-Produktion der Royal Shakespeare Company von 2023 nutzt Ambisonics zur räumlichen Darstellung der magischen Inszenierungselemente (Bild: Ikin Yum / RSC)
Die Ära der rein frontalen Beschallung verliert an Bedeutung. In Konzerthäusern, Theatern und bei hochkarätigen Firmen-events wird Klang zunehmend als dreidimensionales Erlebnis inszeniert. Der Hörer nimmt den Schall nicht mehr nur von vorne wahr, sondern aus allen Richtungen – von links, rechts, oben, unten oder auch von hinten. Was früher dem Kino oder dem Tonstudio vorbehalten war, wird heute zunehmend zur Erwartung an ProAV-Installationen.
Anzeige
Diese immersiven Audioerlebnisse machen Klänge intensiver und räumlich greifbarer. „Im Gegensatz zu Stereo kommt immersives Audio der natürlichen Art und Weise, wie wir die Welt wahrnehmen, sehr nahe“, findet Claudio Vittori, Klangkünstler und Produzent. Treiber dieser Entwicklung sind neben künstlerischen Ansprüchen auch veränderte Anforderungen in der Praxis. Konzerte, Theaterproduktionen und hybride Veranstaltungen verlangen nach flexiblen, skalierbaren und ortsunabhängigen Audiolösungen.
Hinter dieser Entwicklung stehen unterschiedliche technologische Ansätze mit einem jeweils eigenem Modell der Raumabbildung und unterschiedlichen Möglichkeiten für die Praxis. Entscheidend ist nicht die Wahl einer einzelnen Technologie, sondern das Verständnis ihrer jeweiligen Stärken, Grenzen und ihres sinnvollen Zusammenspiels.
Bild: Vittori
„Im Gegensatz zu Stereo kommt Immersive Audio der natürlichen Art und Weise, wie wir die Welt wahrnehmen, sehr nahe“, Claudio Vittori, Klangkünstler und Produzent
Bild: Sony Classical
„Es geht darum, eine Umarmung zu kreieren, die den Zuhörer schützt oder völlig in die
Geschichte hineinzieht“, Hans Zimmer, Filmkomponist und Musikproduzent
Bild: Hochschule für Medien
„Objektbasiertes Audio behandelt jede Schallquelle als eigenständige Einheit. Dadurch wird der Mix zu einer räumlichen Szenenbeschreibung, die nicht mehr von einem spezifischen Wiedergabesystem abhängt“, Frank Melchior, Professor für audiovisuelle Medien an der Stuttgarter Hoch-schule der Medien
Bild: meinungsbarometer.info
Der Renderer kann auf Wunsch dafür sorgen, dass Dialoge lauter und deutlicher wiedergegeben werden als Musik oder Atmosphäre",
Sebastian Goossens, Bereichsleiter Audio/Video am Institut für Rundfunktechnik.
Bild: Brandenburg Labs / Fraunhofer
„Wave Field Synthesis kann die Qualität der Klangreproduk-tion dramatisch steigern. [...] Das Ziel ist die perfekte akustische Illusion – eine
Vision, bei der digitale und reale Welt verschmelzen, indem Schallwellen im gesamten Raum physikalisch korrekt rekonstruiert werden“, MP3-Miterfinder Karlheinz Brandenburg
Bild: Linkedin
„Der Vorteil von Ambisonics ist die Rotationsinvarianz: Man kann das gesamte Klangfeld verlustfrei drehen. Das macht es zum perfekten Format für VR“, Matthias Kronlachner, Audio-Algorithmus-Experte
Ambisonics: Flexibilität durch Schallfeldbeschreibung
Ambisonics beschreibt das gesamte Schallfeld an einem Punkt im Raum – nicht einzelne Klangquellen auf bestimmte Lautsprecher. Das Signal wird im sogenannten B-Format kodiert und enthält keine festen Lautsprecherzuweisungen, sondern eine abstrakte räumliche Beschreibung. Die Abbildung auf ein konkretes Lautsprecherlayout erfolgt erst im Decoder. Genau diese Trennung von Aufnahme und Wiedergabe ist das entscheidende Merkmal des Verfahrens.
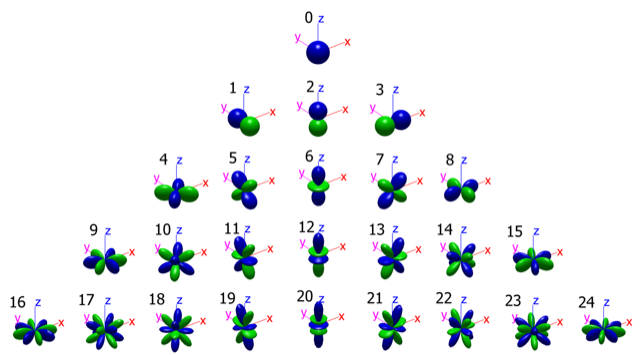
Bei Ambisonics werden die vollständigen räumlichen Informationen durch Signale auf Basis von Kugelflächenfunktionen (spherical harmonics) dargestellt, deren Ordnung jeweils zunimmt. Mit steigender Ordnung erhöht sich die Anzahl der Signale; die Richtcharakteristiken der virtuellen Mikrofone sind in dieser Grafik dargestellt (Bild: www.angelofarina.it/TBE-conversion-new.htm )
Das ermöglicht eine hohe Flexibilität: Ein einmal aufgenommenes Schallfeld lässt sich auf unterschiedlichste Wiedergabesysteme übertragen – von Stereo über komplexe Lautsprecheranordnungen bis zur binauralen Wiedergabe über Kopfhörer. Die sogenannte Ordnung des Ambisonics-Formats bestimmt die Richtungsauflösung: Höhere Ordnungen liefern eine präzisere Lokalisation, erfordern aber mehr Kanäle und Rechenleistung.
Für VR-Anwendungen ist Ambisonics besonders geeignet, weil das Schallfeld in Echtzeit an Kopfbewegungen angepasst werden kann. „Der Vorteil von Ambisonics ist die Rotationsinvarianz: Man kann das gesamte Klangfeld verlustfrei drehen. Das macht es zum perfekten Format für VR, wo sich der Klang mit der Kopfbewegung mitdrehen muss,“ erläutert Matthias Kronlachner, ein Experte für Audio-Algorithmen (www.matthiaskronlachner.com).
Im Live- und Produktionsumfeld ermöglicht Ambisonics, Konzertmitschnitte oder Raumklänge so aufzunehmen, dass sie später flexibel in unterschiedlichen Wiedergabe-szenarien eingesetzt werden können – ohne sich früh auf ein Lautsprecherlayout festlegen zu müssen. Die Produktion bleibt bis zum letzten Schritt offen und anpassbar, was gerade bei komplexen Tour-Setups oder wechselnden Spielstätten ein erheblicher praktischer Vorteil ist. Auch in Theater- und Medienproduktionen kommt das Verfahren zum Einsatz, wenn Klangbewegungen präzise im Raum choreografiert werden müssen. Ein Beispiel ist die Produktion „The Tempest“ am Royal Shakespeare Theatre, bei der Ambisonics zur räumlichen Darstellung der magischen Inszenierungselemente genutzt wurde. Die Möglichkeit, das gesamte Klangfeld unabhängig von der Wiedergabeumgebung zu steuern, eröffnet kreative Spielräume, die mit kanalbasierten Ansätzen nicht realisierbar wären.
Wave Field Synthesis: Physikalische Rekonstruktion mit hohem Aufwand
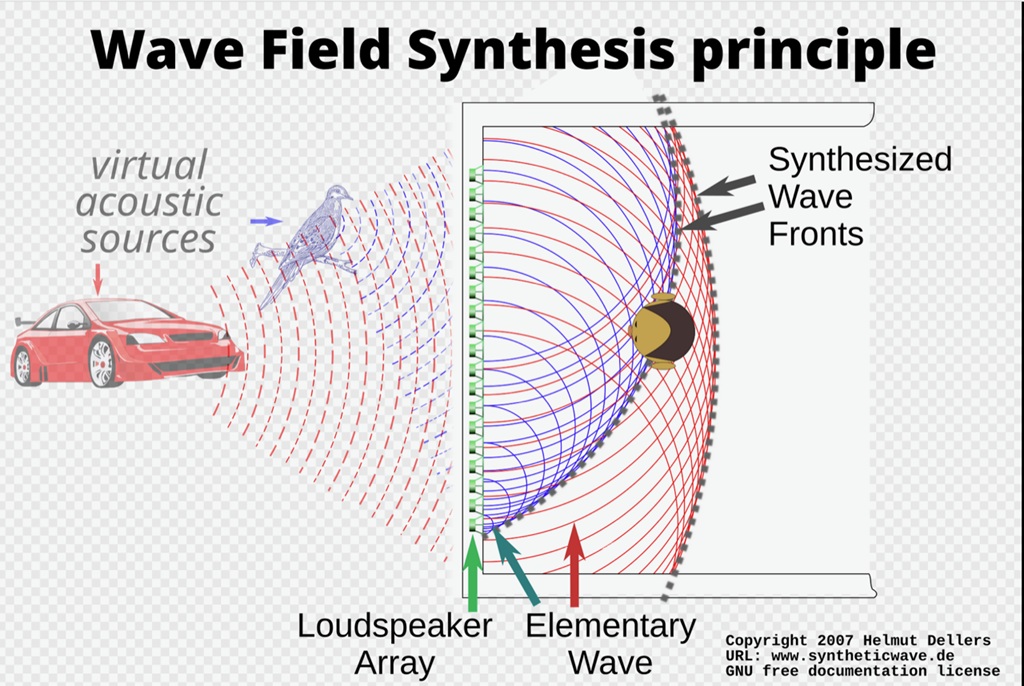
Wave Field Synthesis (WFS) rekonstruiert die Schallwellenausbreitung physikalisch exakt – auf Basis des Huygens-Prinzips, nach dem jeder Punkt einer Wellenfront als Ausgangspunkt einer neuen Elementarwelle betrachtet wird. Eine große Anzahl dicht angeordneter Lautsprecher erzeugt durch präzise verzögerte Einzelsignale eine resultierende Wellenfront, die sich im Raum so ausbreitet, als würde sie von einer realen Schallquelle ausgehen. Das Ergebnis: eine sehr stabile räumliche Abbildung, die für mehrere Zuhörer konsistent bleibt – unabhängig von ihrer Position im Raum.
Klangquellen können frei positioniert werden, auch vor oder hinter dem Lautsprecherarray. Damit unterscheidet sich WFS grundlegend von klassischen Surround-Systemen, die stark vom Sweet Spot abhängen. „Wave Field Synthesis kann die Qualität der Klangreproduktion dramatisch steigern. Das Ziel ist die perfekte akustische Illusion – eine Vision, bei der digitale und reale Welt verschmelzen, indem Schallwellen im gesamten Raum physikalisch korrekt rekonstruiert werden,“ heißt es vom MP3-Miterfinder Karlheinz Brandenburg. Der Preis für diese Präzision ist ein erheblicher technischer Aufwand. WFS-Systeme erfordern eine große Anzahl eng beieinander platzierter, individuell angesteuerter Lautsprecher. Für eine überzeugende räumliche Auflösung können mehrere hundert Kanäle notwendig werden.
Wave Field Synthesis erzeugt künstliche Wellenfronten, die durch eine große Anzahl einzeln angesteuerter Lautsprecher aus Elementarwellen synthetisiert werden (Bild: Helmut Dellers, via Wikimedia Commons (syntheticwave.de), GFDL.)
Die Kalibrierung ist kritisch: Da WFS auf präziser Wellenüberlagerung basiert, führen bereits kleine Abweichungen in Laufzeit oder Pegel zu hörbaren Artefakten. Moderne Systeme setzen für die Signalverarbeitung auf leistungsfähige DSP-Architekturen, die große Kanalzahlen mit minimaler Latenz verarbeiten.
Aufgrund dieses Aufwands wird WFS vor allem in spezialisierten Installationen eingesetzt. Ein eindrückliches Beispiel dafür ist das Institut für Computer Music and Sound Technology (ICST) der Zürcher Hochschule der Künste: Dort wurde 2025 ein System mit 256 einzeln ansteuerbaren Lautsprechern in Betrieb genommen, das fokussierte Schallquellen erzeugt – diese erscheinen für den Hörer nicht als abstrahlende Lautsprecher, sondern als frei im Raum positionierte Klangereignisse. Vergleichbare Installationen betreiben das Institut für Sonologie in Den Haag (192 Lautsprecher) und das Fraunhofer IDMT (Ilmenau). Für kommerzielle Live-Anwendungen sind effizientere Verfahren wirtschaftlich attraktiver.
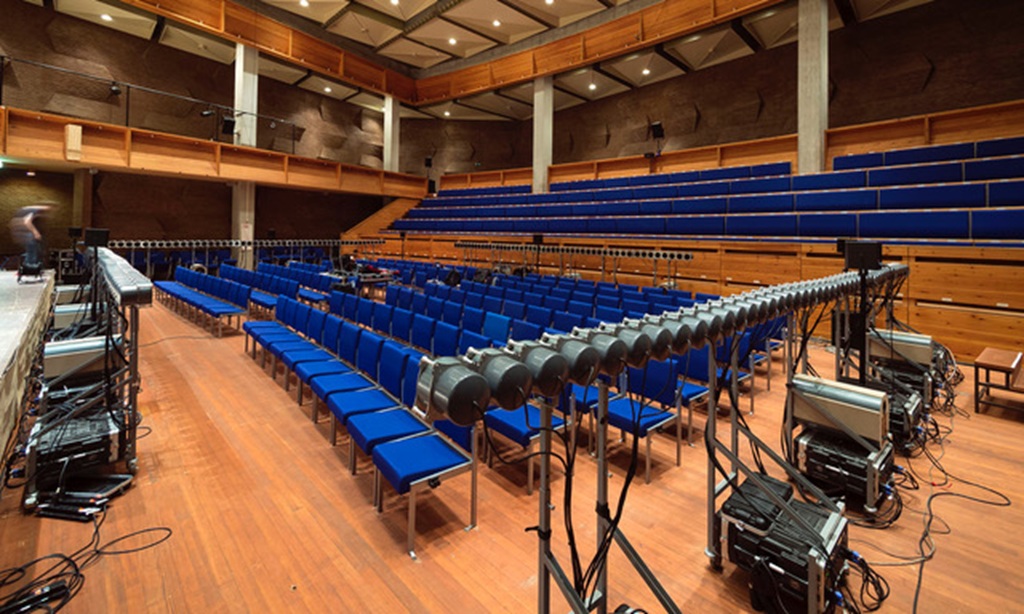
Eine Wave-Field-Synthesis-Installation mit 192 Lautsprechern und 8 Subwoofern wird vom niederländischen Institut für Sonologie intensiv genutzt (Bild: Royal Conseratoire The Hague)
Objektbasiertes Audio: Der dominierende Ansatz im professionellen Bereich
Der derzeit prägendste Ansatz im professionellen Audiobereich ist objektbasiertes Audio. Klangquellen werden nicht mehr festen Kanälen zugewiesen, sondern als frei positionierbare Objekte im Raum behandelt. Jedes Audiosignal – eine Stimme, ein Instrument, ein Effekt – erhält Metadaten, die Position, Ausdehnung und Bewegung im dreidimensionalen Raum beschreiben. Das Audiosignal selbst bleibt dabei vom Wiedergabesystem entkoppelt. „Objektbasiertes Audio behandelt jede Schallquelle als eigenständige Einheit. Dadurch wird der Mix zu einer räumlichen Szenenbeschreibung, die nicht mehr von einem spezifischen Wiedergabesystem abhängt. Dies macht Audioinhalte immersiver, interaktiver und zugänglicher,“ erläutert Frank Melchior, Professor für audiovisuelle Medien an der HdM Stuttgart.
Die Zuordnung zu Lautsprechern erfolgt nicht im Mischprozess, sondern erst bei der Wiedergabe durch einen Renderer. Dieser berechnet in Echtzeit, welcher Lautsprecher welches Signal mit welchem Pegel und welcher Laufzeit wiedergeben muss – auf Basis der Objektmetadaten und der konkreten Lautsprecherkonfiguration vor Ort. Das hat eine hohe Flexibilität zur Folge: Eine Produktion kann auf unterschiedlichen Systemen wiedergegeben werden – vom Kopfhörer über Heimkino bis zur komplexen Beschallungsanlage. Gleichzeitig verbessert sich die räumliche Konsistenz im Publikum: Stimmen und Klang-ereignisse werden dort wahrgenommen, wo sie visuell verortet sind, unabhängig davon, ob sich der Zuhörer mittig oder am Rand befindet.
2025 stellte das Institute for Computer Music and Sound Technology der Zürcher Hochschule der Künste sein neues Wave-Field-Synthesis-Array fertig. Das System besteht aus acht speziell angefertigten Modulen mit je 32 Kanälen, die zusammen eine durchgehende Reihe von 256 einzeln ansteuerbaren Lautsprechern bilden (Bild: Rama Gottfried/ICST)
Zu den wichtigsten Formaten des objektbasierten Audio gehören Dolby Atmos, DTS:X und MPEG-H. Im Live-Bereich dominieren spezialisierte Plattformen wie L-ISA von L-Acoustics, Soundscape von d&b audiotechnik und Spacemap Go von Meyer Sound. Diese Systeme kombinieren eine objektbasierte Steuerung mit spezialisierten Rendering-Engines und sind auf die Anforderungen von Touring-Produktionen und festen Installationen zugeschnitten.
Dass sich das Feld der spezialisierten Live-Plattformen weiter an Breite gewinnt, zeigt die Sound-xR-Initiative, die Yamaha auf der ISE 2025 in Barcelona vorgestellt hat. Die Kooperation zwischen Yamaha, NEXO und Steinberg zielt darauf ab, objektbasiertes Audio auch unterhalb der High-End-Schwelle zugänglich zu machen – für Mehrzweckhallen, Themenparks oder mittelgroße Veranstaltungsorte, die bislang kaum im Fokus immersiver Systemlösungen standen.
Im Zentrum steht AFC Image für den Yamaha DME7-Prozessor, der in Kombination mit Yamahas Lautsprechersortiment kompakte immersive Setups ermöglichen soll. NEXO ergänzt das Portfolio mit dem DME10, einem 256×256-Dante-fähigen Prozessor mit objektbasiertem Mischen und 3D-Hall. Steinbergs Nuendo wiederum fungiert als Produktionsseite des Workflows und lässt sich über OSC nahtlos in Drittsysteme einbinden. „Die einzigartigen Technologien der Yamaha-Gruppe sorgen für einen durchgängigen Workflow – von der Content-Erstellung bis zum Konsum“, erklärt Tobias Weich, Director ProAudio Europe bei Yamaha Music Europe.
Große Tourproduktionen nutzen objektbasiertes Audio seit Jahren intensiv: Dolby Atmos kommt etwa bei Produktionen von Billie Eilish zum Einsatz, um ein 3D-Klangbild zu erzeugen, welches das Publikum vollständig umgibt. Im Theater ermöglicht der Ansatz, Geräusche, Stimmen und Effekte frei im Raum zu choreografieren – wie bei »The Lion King« am Broadway, wo Naturklänge und Tierstimmen präzise im Raum platziert wurden.
VBAP: Effizientes Rendering für die Live-Praxis
In realen Produktionsumgebungen spielt Vector Base Amplitude Panning (VBAP) eine zentrale Rolle als Rendering-Verfahren. Eine Klangquelle wird nicht einem einzelnen Lautsprecher zugewiesen, sondern zwischen zwei oder drei benachbarten Lautsprechern »aufgespannt«: Aus den jeweiligen Pegelverhältnissen entsteht für das Publikum der Eindruck einer definierten Position im Raum. Viele moderne Spatial-Audio-Plattformen – darunter L-ISA und Soundscape – nutzen VBAP oder ähnliche Verfahren beim Rendering.
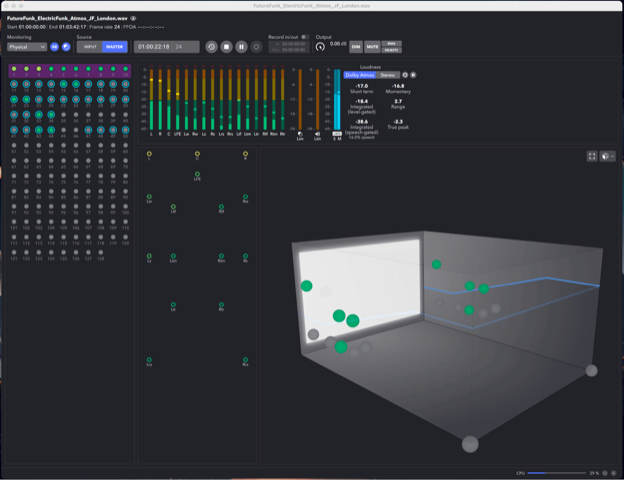
Bei objektbasiertem Audio wie Dolby Atmos wird Sound nicht mehr in Kanälen, sondern in Objekten gedacht. Diese Renderer-UI positioniert Klänge als Punkte in einem dreidimensionalen Raum (Bild: Fraunhofer IDMT)
Für Konzerte, Theater und Eventproduktionen ist das ein entscheidender Vorteil: Klangobjekte lassen sich flexibel im Raum bewegen, die Infrastrukturanforderungen bleiben beherrschbar – ohne die Komplexität von Wave Field Synthesis. Die räumliche Abbildung ist näherungsweise; ihre Qualität hängt von Lautsprecherlayout, Hörposition und Raumakustik ab. In der Praxis ist das für die meisten Live-Anwendungen kein Nachteil, sondern ein vertretbarer Kompromiss zwischen Präzision und Aufwand.
Binaurales Audio: Immersion über Kopfhörer
Für hybride und mobile Szenarien ist binaurales Audio der entscheidende Baustein. Grundlage sind sogenannte Head-Related Transfer Functions (HRTFs), die modellieren, wie Schall durch Kopf und Ohrmuschel beeinflusst wird. Daraus entsteht ohne jede Lautsprecherinstallation der Eindruck räumlicher Tiefe und Richtung über Kopfhörer.
Der große Vorteil: Immersive Hörerlebnisse sind unabhängig von physischer Infrastruktur möglich – etwa im Streaming, in mobilen Anwendungen und in XR-Szenarien. Binaurales Audio fungiert dabei häufig als Zielformat für objektbasierte oder Ambisonics-basierte Produktionen: Derselbe inhaltliche Mix wird parallel für unterschiedliche Ausgabekanäle gerendert. Bei Hybrid-Events bedeutet das, dass Online-Zuschauer konsistent über unterschiedliche Wiedergabesysteme hinweg dieselbe räumliche Erfahrung erhalten wie das Vor-Ort-Publikum.
Die räumliche Wahrnehmung hängt stark von den verwendeten HRTF-Modellen ab und ist nicht für alle Hörer gleichermaßen überzeugend, da individuelle Unterschiede in Kopf- und Ohrgeometrie die Lokalisation beeinflussen. Personalisierte HRTF-Profile, die auf Basis von Messungen oder KI-gestützter Schätzung erzeugt werden, versprechen hier deutliche Verbesserungen. Dieses lebendige Forschungs- und Entwicklungsfeld dürfte in den nächsten Jahren zunehmend in Produktlösungen einfließen. Dennoch ist binaurales Audio auch heute schon ein zentraler Baustein immersiver Audiostrategien – gerade dort, wo räumliche Inhalte unabhängig von physischer Infrastruktur zugänglich gemacht werden müssen.
Systemarchitektur: Das Zusammenspiel entscheidet
In der Praxis erfolgt die Realisierung immersiver Audiolösungen über integrierte Systemarchitekturen, nicht über isolierte Einzellösungen. Im Zentrum steht eine mehrstufige Signalkette: Audioquellen wie Mikrofone, Zuspieler oder Inhalte von Digital-Audio-Workstations (DAW) werden in einem Mischsystem verarbeitet, häufig bereits objektbasiert. Die Daten werden an eine Rendering-Engine übergeben, um die konkrete Lautsprecheransteuerung zu berechnen: Pegel, Laufzeit und Filterung für jedes einzelne Lautsprechersignal in Echtzeit. Die Signalverarbeitung erfolgt in spezialisierten DSP-Plattformen; die Verteilung typischerweise über IP-basierte Netzwerke wie Dante oder AES67. Die Mischkonsole bleibt dabei wichtig, wird aber weniger zum alleinigen Verteiler. Die eigentliche Signalverarbeitung verlagert sich zunehmend in Renderer und Backend-Systeme.
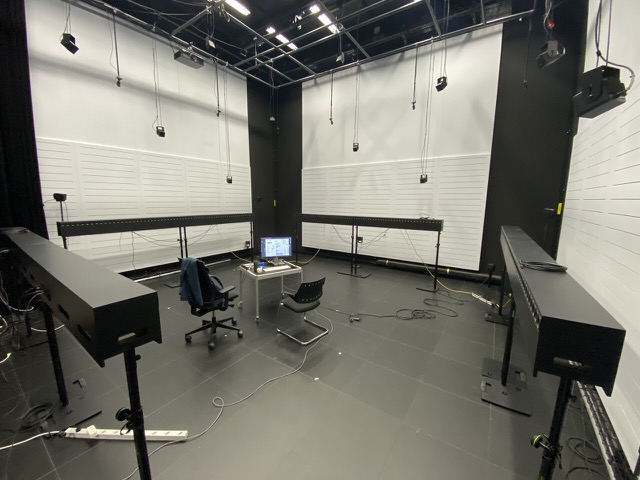
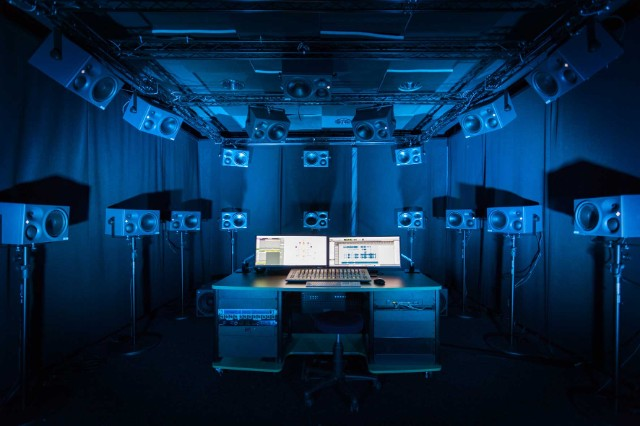
Das Fraunhofer IDMT ist weltweit führend in der Entwicklung von Audiosystemen. Dieses festinstallierte Soundsystem dient der Weiterentwicklung von Technologien zur räumlichen Audiowiedergabe auf Basis von WFS (Bild: Fraunhofer DMT)
Je nach dem zugrunde liegenden Ansatz variieren die Anforderungen allerdings erheblich. Ambisonics reagiert flexibel auf unterschiedliche Lautsprecherlayouts und lässt sich vergleichsweise unkompliziert in bestehende Infrastrukturen integrieren. WFS erfordert eine hohe Lautsprecherdichte und eine präzise Kalibrierung. Das ist ein kritischer Faktor, da bereits kleine Abweichungen hörbare Artefakte erzeugen.
Objektbasierte Systeme bieten derzeit die größte Anpassungsfähigkeit und sind im Live- und Eventkontext am weitesten verbreitet. Für hybride Anwendungen wird die Architektur häufig durch binaurales Rendering ergänzt: Derselbe Audiomix wird parallel für die Kopfhörerwiedergabe aufbereitet, damit Remote-Teilnehmer ein räumlich konsistentes Erlebnis erhalten.
Fazit & Ausblick: Kombination statt Monokultur
Immersive Audio basieret nicht auf einem einzelnen Verfahren, sondern auf dem Zusammenspiel verschiedener Ansätze. Ambisonics, Wave Field Synthesis und objektbasiertes Audio bilden die konzeptionelle Grundlage; Verfahren wie VBAP und binaurales Rendering ermöglichen die Umsetzung in realen Anwendungen.
In der Praxis dominiert daher nicht eine Technologie, sondern eine Kombination: Objektbasierte Systeme haben sich im Live-Bereich etabliert, Ambisonics ist zentral für XR-Anwendungen, binaurales Audio erschließt mobile und hybride Nutzungsszenarien.
Für AV-Planer bedeutet das einen Perspektivwechsel: Nicht mehr das Routing von Kanälen steht im Mittelpunkt, sondern die Gestaltung von Klangräumen – bei gleichzeitig steigenden Anforderungen an Systemarchitektur, Integration und Kalibrierung.
Die Entwicklung ist mit dem beschriebenen Status quo keineswegs abgeschlossen. Sie markiert vielmehr den Übergang zu einer neuen Generation räumlicher Audiotechnik und den Beginn eines neuen Planungsverständnisses, bei dem Klang nicht mehr verteilt, sondern inszeniert wird.
Quick Guide für AV-Planer
Anwendung definieren: Konzert, Theater, Installation oder Hybrid-Event stellen unterschiedliche Anforderungen an Präzision und Skalierbarkeit. Daraus ergibt sich die Technologiewahl.
Lautsprecherlayout strategisch planen: Surround- und Height-Ebenen von Beginn an mitdenken, nicht erst nachträglich. Entscheidend ist die gleichmäßige Abdeckung des Publikumsbereichs, nicht die maximale Kanalzahl.
Rendering-Konzept festlegen: In vielen Systemen kommen in der Praxis amplitudenbasierte Verfahren wie VBAP zum Einsatz. Sie bieten eine flexible Anpassung an diverse Layouts, bewährt im Live-Betrieb.
Systemleistung realistisch dimensionieren: Echtzeit-Rendering, Delay-Management und Raumanpassung erfordern stabile, latenzarme Systeme. Dedizierte DSP-Plattformen sind essenziell.
Netzwerkarchitektur mitdenken: Hohe Kanalzahlen setzen auf IP-basierte Netzwerke (Dante, AES67).
Redundanz, Clocking und Latenzmanagement sind integraler Bestandteil der Planung.
Hybridfähigkeit einplanen: Binaurales Rendering von Anfang an berücksichtigen, um eine konsistente Wiedergabe für Remote-Teilnehmer über Kopfhörer zu gewährleisten.
Kalibrierung als eigenen Projektschritt behandeln: Einmessung, Laufzeitkorrektur und Pegelabstimmung sind entscheidend, insbesondere bei komplexen Lautsprecherlayouts.